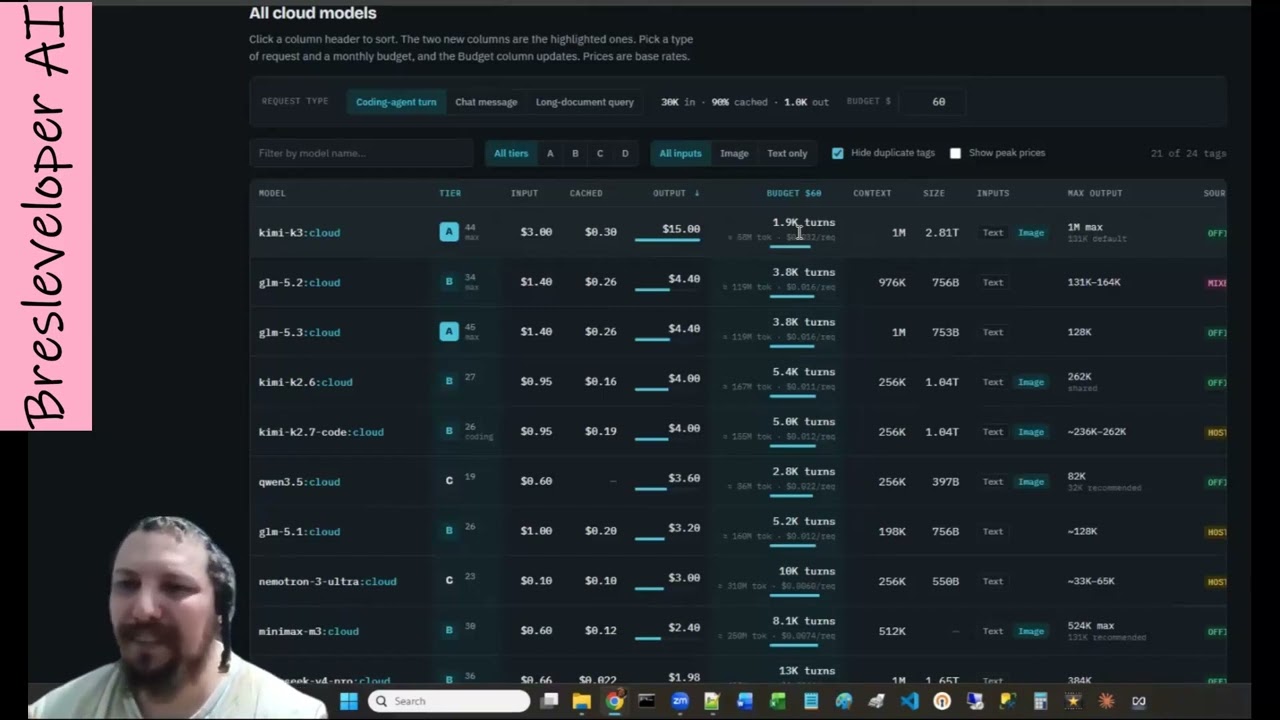
OLLAMA שינתה את התמחור. במקום רמות השימוש הישנות — נמוך, בינוני, גבוה, מאוד גבוה — הכל מוצג עכשיו כתקציב דולרי חודשי גולמי. זה נשמע ברור יותר, אבל בפועל זה מקשה עוד יותר לנחש מה בכלל מקבלים. הסרטון הזה הוא הניסיון של אריאל לתרגם את המספרים האלה לשימוש אמיתי.
איך נראים התוכניות החדשות
- תוכנית 20$/חודש → תקציב חודשי של 60$
- תוכנית 100$/חודש → תקציב חודשי של 300$
- Teams: 500$/חודש → תקציב חודשי של 1,000$ בתוספת תכונות מתקדמות
התקציב הדולרי הוא מה ששורפים בכל קריאה למודל. השאלה היא: כמה רחוק הוא מגיע?
ניסויים אמיתיים על מודלים
אריאל הריץ בדיקות שימוש אמיתיות. ההבדלים בין המודלים דרמטיים.
- GLM-5.3: מודל כוח שצורך בערך חמישית מתקציב השבוע במהירות גבוהה. מהיר, מסוגל, יקר.
- kimi k2.7: מודל זול יותר שנותן הרבה פחות תשובות ארוכות. עדיין חכם, אך עצלן יותר — נוטה למהר לתשובה ולעצור.
- GLM-5.3-flash: כמעט 3,000 בקשות. על הנייר זה נראה זול, אבל אריאל מצא שבפועל kimi k2.7 זול אפילו יותר, כי GLM-5.3-flash עובד קשה ואילו kimi k2.7 ממהר לסיים. למרות זאת, GLM-5.3-flash מתאמץ יותר לנתח בעיות ונמצא בערך ברמת GPT-4o.
- kimi k3: מודל עוצמה ששרף חתיכה גדולה ב-12 בקשות. המודל החזק ביותר שבדק, אבל גם היקר ביותר.
הוא גם מזכיר את GLM 5.2 / 5.3, Mistral Large / Ultra, DeepSeek V3 Pro, ו-Gemma 4. המודלים הכבדים (GLM 5.3, Mistral Large וכו’) נותנים בערך 1,000 הודעות בשבוע, כלומר כ-200 לכל סשן. מודלים קטנים יותר נמתחים רחוק יותר אבל מאבדים יכולת.
פרט נוסף: GLM 5.3 Pro לא מקבל תמונות — ביטלו את התמונות כדי לשמור עליו חכם ולחסוך בחישוב. הפתרון של אריאל הוא לפתוח תת-סוכן של GLM-5.3-flash שינתח את התמונה, יסביר מה קורה בה, ואז ממשיכים ב-Pro.
בדיקת המציאות של תקציב 60$
אריאל ביקש מהעוזר אומרי (שהריץ אז קוד GLM 5.3) לבנות הערכה לתקציב חודשי של 60$. המתמטיקה הגסה:
- לשבוע: בערך 500 הודעות בסך הכל.
- לסשן: בערך 100 הודעות.
- בשיחה רגילה: התקציב מספיק לערך 4–5 סשנים בשבוע.
- בפיתוח: זה יורד לכ-2–3 סשנים בשבוע.
“תור” כאן פירושו: שולחים בקשה, המודל עובד, עובד, עובד, ומחזיר תשובה סופית. פרומפטים בפיתוח גדולים ולא אחידים, אז זו הערכת עליון, לא הבטחה.
כדי להבהיר: כל משחק התמחור הזה בענן נעלם אם מריצים מודלים מקומית — אבל לזה צריך כרטיס מסך.
המסקנה המעשית
- בתוכנית 20$: GLM 5.3 Pro או Flash הם הבחירה. הם מספיק חכמים לרוב עבודת הקוד וגורמים לתקציב להימתח.
- בתוכנית 100$: אפשר להרשות לעצמך GLM או Mistral Large באופן עקבי יותר.
- kimi k3: להשתמש רק בבעיות מאוד ספציפיות וקשות. הוא המודל היקר ביותר וישרוף תקציב במהירות.
- אופציה מקומית: חבר הריץ את Mistral Mini הקטן על מחשב מקומי והיה מרוצה להפליא. אין תמחור ענן, אבל צריך חומרה.
אריאל גם מציע את גיליון הערכת המחירים שבנה. מי שרוצה אותו — לשאול בתגובות, במייל, או בוואטסאפ.
🔥 Roast Corner
דפי תמחור אוהבים להסתיר את העלות האמיתית מאחורי מילים כמו “Pro”, “ללא הגבלה” ו"שימוש נדיב". ואז הם עוברים לתקציב דולרי גולמי ופתאום כולם עושים חשבון בגיליון. זו לא שקיפות — זו פשוט סוג אחר של בלבול.
הבעיה האמיתית היא שתמחור מודלים הוא לפי טוקן, לפי קריאה, לפי חלון הקשר, עם הנחות על קאש קלט, מכפילי פלט, ואוטו-קומפקציה נסתרת. אדם לא יכול להחזיק את כל זה בראש. אז או שבודקים אמפירית (כמו שאריאל עשה) או שסומכים על דף שיווקי ומופתעים אחר כך.
הלקח: להכיר את המודלים שלך כמו שאתה מכיר את הצוות. יש כאלה זולים ומהירים. יש כאלה יקרים ועמוקים. להתאים את המודל למשימה, או את המשימה לתקציב.
🤖 AI for Humans
דמיינו שיש לכם תקציב טלפון חודשי, אבל כל שיחה עולה סכום שונה תלוי במי אתם מדברים, כמה זמן, וכמה הנושא מורכב. חבר אחד עונה במשפט אחד ומנתק. חבר שני נותן לכם דוקטורט וחשבון.
ככה נראה השימוש ב-AI ענן היום.
החלק המועיל הוא שאפשר לבחור:
- מודלים זולים למשימות פשוטות וחוזרות.
- מודלים בינוניים לכתיבה וקוד יומיומיים.
- מודלים יקרים לבעיות הקשות שבהן טעות עולה יותר מהטוקנים.
הניסוי של אריאל הוא דוגמה מעשית לשימוש מודע בתקציב AI. במקום תמיד להשתמש במודל החדש והגדול ביותר, הוא מדד איזה מודל נותן את התשובה הטובה ביותר לדולר בעבודה האמיתית שלו. זו המיומנות שחשובה יותר מכל דירוג מודל בודד.
פורסם בתאריך 2026-10-04 מתוך הסרטון ב-YouTube של אריאל רובינשטיין.
💬 תגובות