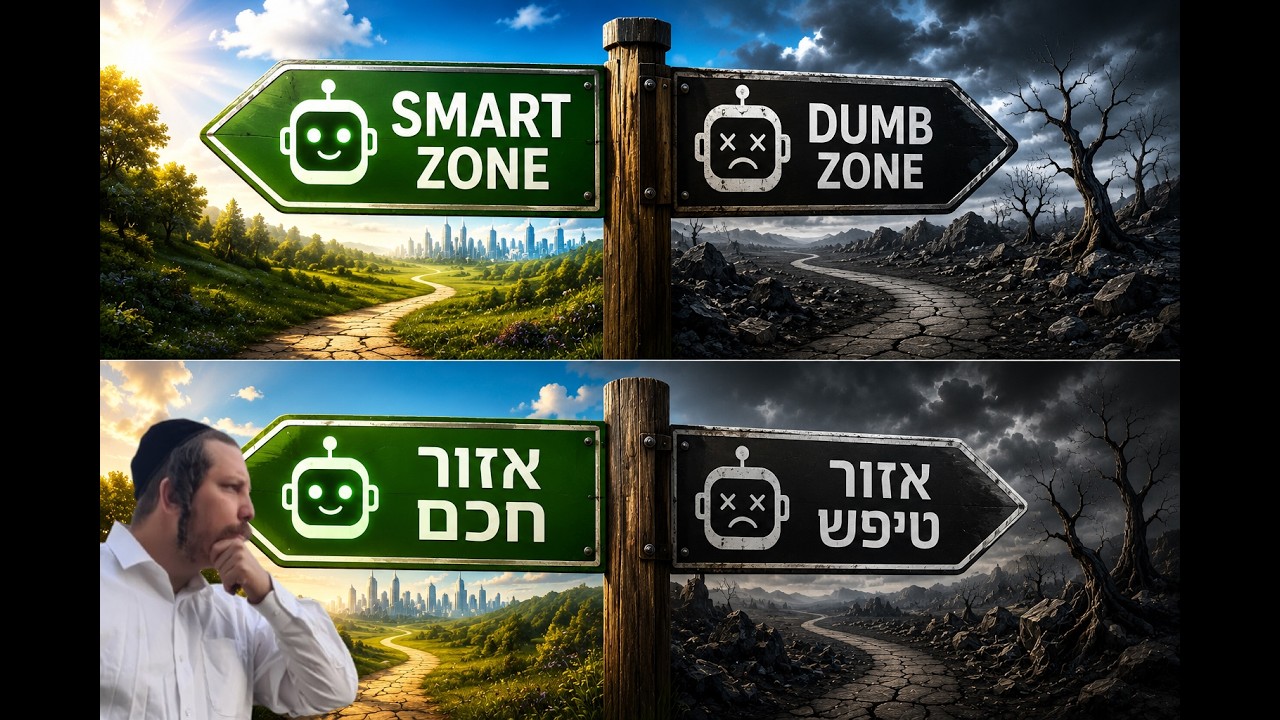
רוב האנשים מתייחסים למודל שפה כמו לקופסת קסם: מכניסים מילים, מקבלים מילים, ולפעם התשובה גאונית ולפעם שטות. הסרטון הזה פותח את הקופסה ומסביר אחד הרעיונים הכי שימושיים בבינה מלאכותית מודרנית: האזור החכם והאזור הטיפש.
אריאל מסביר איך רשת נוירונים מעבדת קלט, למה תשומת הלב היא משאב סופי, ולמה כל שיחה ארוכה בסוף פוגעת בקיר שבו המודל מתחיל לשכוח מה ביקשת בהתחלה.
איך LLM עובד בפועל, בחמש דקות
מתחת למכסה, מודל שפה גדול הוא מחסום של שכבות. כל שכבה בנויה מנוירונים, וכל נוירון מחובר לנוירונים בשכבה הבאה. כשאתה מקליד מילה, המילה הופכת למספר — טוקן — והמספר הזה זורם ברשת.
כל נוירון מריץ פונקציה מתמטית קטנה שנקראת פונקציית ההפעלה. הוא מחליט האם להעביר את האות קדימה או לעצור אותו. בפועל, המודל כל הזמן מדליק חלק מהמסלולים ומכבה אחרים. הארכיטקטורה של “מיקסטורה של מומחים” לוקחת את הרעיון הזה לקצה: במקום להפעיל שני טריליון פרמטרים בבת אחת, המודל מדליק רק את 100 המיליונים החזקים ביותר. השאר נשארים כבויים.
זה כלל פארטו במכנה מכונה. הנוירונים שחשובים יותר עושים את רוב העבודה, ולהתעלם מהשאר מאיץ ומוזיל את המודל בלי להרוס את האיכות.
חיזוי הטוקן הבא, שוב ושוב
המודל לא כותב תשובה שלמה במכה אחת. הוא מנבא טוקן אחד בכל פעם, מכניס את הטוקן הזה בחזרה לקלט, ומנבא את הבא. “החתול הוא…” הופך ל"נחמד," שמתחבר ל"חתול קטן," וכן הלאה.
אז אם שואלים “מה הצבע של החתול,” המודל לא עונה בבזק אחד. הוא מריץ את כל הצינור פעם אחת כדי לייצר “הצבע,” שוב כדי לייצר “הוא,” ושוב כדי לייצר “כחול.” כל מילה עולה עוד מעבר שלם ברשת.
Attention: הצוואר הבקבוק האמיתי
לפני שהטוקנים נכנסים לשכבות, המודל מריץ שלב של attention. הוא מחדש משקלים לקלט כך שמילים חשובות יקבלו יותר פוקוס ומילות מילוי יקבלו פחות. בשאלה “מה הצבע של החתול,” המילים “צבע” ו"חתול" מקבלות משקל גבוה; השאר נדחקות למטה.
החידוש הזה הוא הסוד מאחורי האזור החכם והאזור הטיפש. Attention הוא משאב סופי. למודל יש כמות מרבית של פוקוס שהוא יכול לחלק על פני השיחה. ככל שמצטברות יותר מילים, הפוקוס מתדלדל. ~200,000 הטוקנים הראשונים עדיין חדים כי המילים החשובות שומרות על משקלן. אחרי זה, המודל נכנס לאזור הטיפש: הוא מתחיל לבלבל פרטים, לשכוח מה שאמרת בהתחלה, או לענות על שאלה שלא שאלת.
זה לא באג באימון. זה מגבלה פיזית של תקציב ה-attention.
איך לשמור על האזור החכם
יש שלוש דרכים מעשיות להימנע מהאזור הטיפש:
- להתחיל שיחה חדשה. ברוטלי אבל אפקטיבי. מאבדים את כל ההיסטוריה, אבל מקבלים תקציב attention טרי.
- Auto-compact. המודל מסכם את השיחה למסמך דחוס ומתחיל שיחה חדשה מתקציר זה. נשמר הרוח, אבל נאבדים פרטים.
- שימוש בסוכנים משנה או hand-offs. מפצלים את העבודה בין מספר סשנים ממוקדים, שבכל אחד יש הקשר צר וטרי. לכן מתכנתים אוהבים סוכנים משנה: כל סוכן מקבל אזור חכם משלו למשימה הספציפית שלו.
הרבה מודלים מתקדמים היסטורית הגבילו הקשר ל-256K טוקנים בדיוק מהסיבה הזו. למה לפרסם חלון ענק אם כל מה שמעבר ל-200K טוקנים הוא מטושטש?
זיכרון ששורד דחיסה
Auto-compact שימושי אבל אובדני. החלטות חשובות יכולות להתמוסס בקיצור. הנוהג הטוב יותר הוא לשמור קובץ החלטות או יומן החלטות: קובץ שבו כל החלטה משמעותית נרשמת במפורש.
לפרויקטים בינוניים, קובץ markdown מספיק. לפרויקטים גדולים יותר, עוברים למסד נתונים שהסוכן יכול לשאול אותו. לידע ענק ולא מובנה, משתמשים במסד נתונים סמנטי עם embeddings — זה הבסיס של RAG. המודל שומר ייצוגים משוקללים של מושגים, כך שכששואלים על “מכונית” הוא יכול להעלות גם מידע על “רכב.”
לנתונים שמבוססים על יחסים — מי עבד איפה, למי דווח — מסד נתונים גרפי הוא הצורה הנכונה. הוא מאפשר למודל להסיק מסקנות על פני קשרים, בדומה לאיך LinkedIn ממפה רשתות מקצועיות.
🔥 Roast Corner
הביטוי “אזור חכם” נשמע כמו פטנט שיווקי, אבל למעשה זו דרך מנומסת לומר “לדג הזה יש זיכרון של דג ואתה מאכיל אותו יותר מדי פתיתים.”
אנשים אוהבים להתהדר בחלונות הקשר של מיליון טוקנים, אבל חלון ענק לא אומר שהמודל מקשיב לכל מה שבתוכו. זה אומר שיש לו יותר חבל לפתוח איתו את הקשר. האזור החכם הוא פיקציה מעשית שאנחנו משתמשים בה כדי להתחיל שהמודל נשאר חד. הוא לא. הוא רק נשאר חד מספיק עבור רוב המשימות.
Auto-compact הוא המקבילה של AI לבקש ממישהו לקחת פתקים בישיבה ואז לשרוף את ההקלטה. הפתקים טובים עד שצריך את הניסוח המדויק של החלטה, ואז מגלים שהתקציר כתב “דיברנו על חתולים” כשבפועל הסכמנו שהחתול כחול.
🤖 AI for Humans
דמיין את attention כמו פנס בחדר חשוך. החדר יכול להיות ענק, אבל קרן האור שלך רחבה רק כל כך. כשהחדר ריק, אתה רואה בבירור כל מה שאתה מכוון אליו. כשהחדר עמוס ברהיטים, הקרן מתפזרת ואתה מתחיל לפספס פרטים.
שיחה ארוכה עם LLM זה אותו דבר. בהתחלה הקרן צרה. כל מילה חשובה. בהמשך, הקרן מתפשטת על מאות אלפי טוקנים, והמודל מתחיל לנחש איזו צללית היא החתול.
הפתרון הוא לא לבנות פנס חזק יותר — זה יקר ובסוף בלתי אפשרי. הפתרון הוא לנקות את החדר. לסכם, לפצל משימות, לרשום החלטות, ולתת לסוכנים שונים לטפל בפינות שונות. הדרך החכמה ביותר להשתמש ב-AI היא לא לשפוך הכל לשיחה אחת. היא לשמור על כל שיחה קטנה מספיק כדי שהקרן תישאר בהירה.
פורסם בתאריך 2026-08-27 מתוך סרטון YouTube של אריאל רובינשטיין.
💬 תגובות